Cara Error Handling di n8n agar Workflow Tidak Gagal Diam-Diam
 Clovertechno
5 September 2026
4 menit baca
Ada satu jenis kegagalan otomasi yang jauh lebih mahal dari yang lain: kegagalan yang tidak ketahuan. Workflow laporan yang mati sejak Selasa baru ketahuan Jumat, dan selama tiga hari tim mengambil keputusan dari angka yang tidak pernah diperbarui. Workflow yang gagal dengan berisik itu merepotkan; workflow yang gagal dengan sunyi itu berbahaya. Tutorial ini memasang alarm dan jaring pengaman di instalasi n8n Anda, dalam empat langkah yang urutannya disengaja.
Cara n8n berperilaku saat node gagal
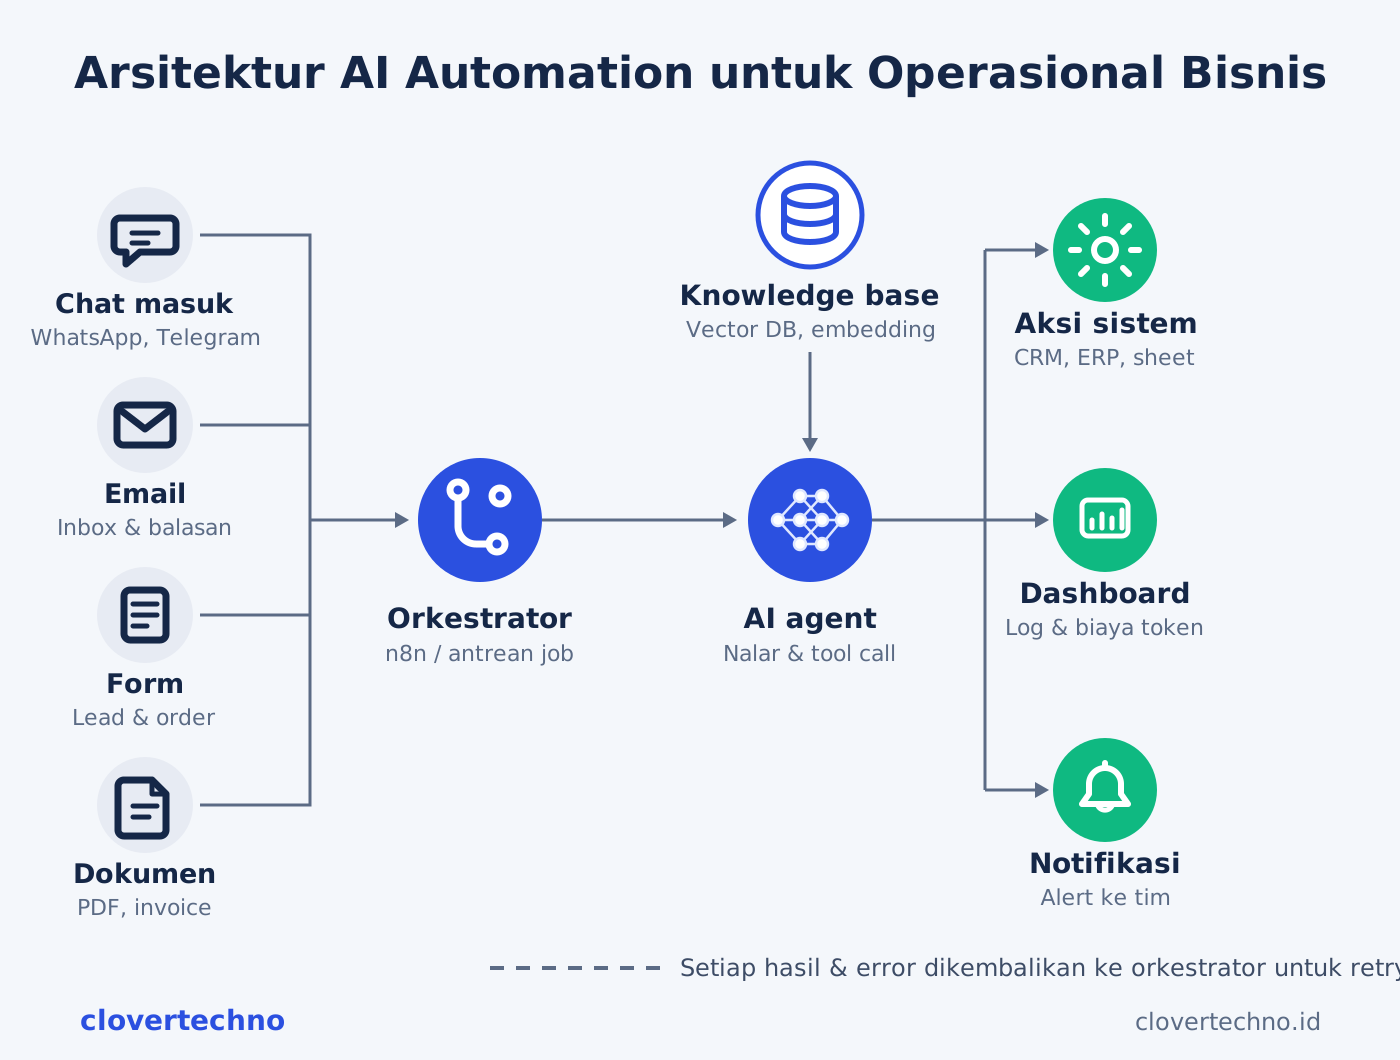
Perilaku bawaannya: satu node melempar error, seluruh eksekusi berhenti di situ, dan catatan gagalnya tersimpan di daftar Executions — menunggu dibuka. Tidak ada email, tidak ada bunyi. Untuk workflow yang Anda jalankan manual sambil ditonton, itu cukup. Untuk workflow terjadwal yang jalan jam lima pagi, "menunggu dibuka" sama dengan tidak ada.
Perlu dipahami juga dua kelas kegagalan yang berbeda obatnya: galat sistem (API tujuan tumbang, koneksi putus, kuota habis) yang biasanya sembuh sendiri kalau dicoba ulang, dan galat data (field kosong, format tak terduga, tanggal ditulis aneh) yang akan gagal lagi seribu kali pun dicoba. Menyamakan keduanya adalah akar kebanyakan penanganan error yang buruk.
Langkah 1: Baca log eksekusi dengan benar
Buka tab Executions, klik eksekusi yang merah. n8n menunjukkan persis node mana yang gagal, data apa yang masuk ke node itu, dan pesan error-nya. Tiga informasi itu menjawab hampir semua pertanyaan "kenapa gagal" — kebiasaan membacanya sebelum mengutak-atik apa pun menghemat jam-jam menebak. Sekalian atur retensi: simpan juga data eksekusi yang sukses selama masa stabilisasi workflow baru, supaya Anda bisa membandingkan eksekusi sehat dan yang sakit.
Langkah 2: Buat Error Workflow untuk notifikasi kegagalan
Ini langkah dengan rasio manfaat-per-menit terbesar di seluruh artikel ini:
- Buat workflow baru bernama "Alarm kegagalan". Node pertamanya: Error Trigger.
- Sambungkan ke pengirim pesan — Telegram paling praktis. Isi pesannya dari data yang disediakan Error Trigger: nama workflow, node yang gagal, pesan error, dan tautan ke eksekusinya.
- Di setiap workflow penting: buka Settings → Error workflow, pilih "Alarm kegagalan".
Sejak menit itu, tidak ada lagi kegagalan sunyi: workflow mana pun yang tumbang mengirim kabar sendiri. Uji dengan sengaja — rusakkan satu URL di workflow percobaan dan pastikan alarm berbunyi. Alarm yang belum pernah diuji berbunyi dianggap belum ada.
Langkah 3: Atur retry di node yang rawan
Untuk galat sistem yang sembuh sendiri, buka pengaturan node yang memanggil layanan luar (HTTP Request, API pihak ketiga) dan aktifkan Retry On Fail — misalnya tiga percobaan berjarak beberapa detik. Gangguan jaringan sekejap pun tak lagi menggagalkan eksekusi.
Dua peringatan yang menjaga retry tetap obat dan bukan racun: jangan pasang retry pada operasi yang berdampak ganda kalau diulang (mengirim pesan, membuat invoice — pelanggan tidak perlu ditagih tiga kali), dan jangan berharap retry menyembuhkan galat data — data salah dicoba ulang lima kali hasilnya salah lima kali.
Langkah 4: Pisahkan galat data dari galat sistem
Untuk galat data, jalurnya bukan retry melainkan karantina. Polanya: node validasi (IF atau Filter) di awal alur memeriksa field wajib dan format; item yang lolos berjalan normal; item yang tidak lolos dibelokkan ke cabang sendiri — dicatat ke sheet "perlu dicek manusia" dan dilaporkan sekali sehari, bukan menghentikan seluruh alur. Beberapa node juga mendukung pengaturan On Error → Continue (using error output), yang memberi cabang error eksplisit di kanvas untuk pola yang sama.
Hasil akhirnya: seribu item diproses, tiga yang aneh masuk karantina, alur tetap selesai, dan manusia menangani tiga — bukan menelusuri seribu.
Pola yang membuat workflow tampak sehat padahal salah
Kegagalan paling licik tidak berwarna merah. Waspadai tiga ini:
- Sukses kosong: eksekusi hijau karena sumber datanya berubah dan filter tak lagi menangkap apa pun. Obatnya: cek jumlah item di titik kunci, dan beri kabar kalau nol padahal biasanya tidak.
- API membalas 200 berisi error: beberapa layanan mengembalikan status sukses dengan pesan galat di dalam body. Periksa isi respons, bukan cuma statusnya.
- Ekspresi yang diam-diam kosong: field yang salah eja menghasilkan teks kosong, bukan error — pesan tetap terkirim, isinya bolong. Obatnya: validasi hasil sebelum dikirim.
Error handling yang baik tidak membuat workflow tak pernah gagal — itu mustahil selama API luar bisa tumbang dan manusia bisa salah ketik. Ia membuat setiap kegagalan ketahuan cepat, terpetakan jelas, dan berhenti di tempat yang benar. Itu beda antara otomasi yang dipercaya tim dan yang diam-diam ditinggalkan.
Fondasi sebelum ini semua: workflow pertama di n8n. Dan kalau Anda ingin sistem otomasi yang sejak hari pertama dirancang dengan jalur gagal yang benar, itulah standar kerja layanan AI automation kami.