Cara Klasifikasi Tiket Support Otomatis dengan AI di n8n
 Clovertechno
23 September 2026
4 menit baca
Inbox support diproses dengan aturan antre yang salah: urut kedatangan. Akibatnya pertanyaan "kapan buka?" yang datang jam 8 dilayani sebelum "pembayaran saya terpotong dua kali" yang datang jam 9 — dan pelanggan dengan masalah paling serius menunggu paling lama di belakang pertanyaan paling ringan. Triase manual bisa membereskannya, tapi triase manual berarti seseorang membaca semua pesan dua kali. Klasifikasi AI mengerjakan pembacaan pertama itu dalam hitungan detik: memberi label, menilai urgensi, dan melempar yang genting ke jalur cepat sebelum manusia mana pun sempat membuka inbox.
Masalah triase manual di inbox support
Tiga kegagalan yang terjadi setiap hari tanpa terlihat: yang urgent tenggelam (tidak ada penanda selain isi pesannya sendiri), tenaga terbuang (orang berpengalaman membaca puluhan pertanyaan yang bisa dijawab siapa saja), dan tidak ada data (di akhir bulan tak ada yang tahu keluhan jenis apa yang paling banyak — padahal itu peta perbaikan bisnis yang gratis). Klasifikasi otomatis menyelesaikan ketiganya sekaligus, karena label yang sama yang mengurutkan antrean juga menjadi statistik.
Langkah 1: Kumpulkan tiket masuk ke satu pintu
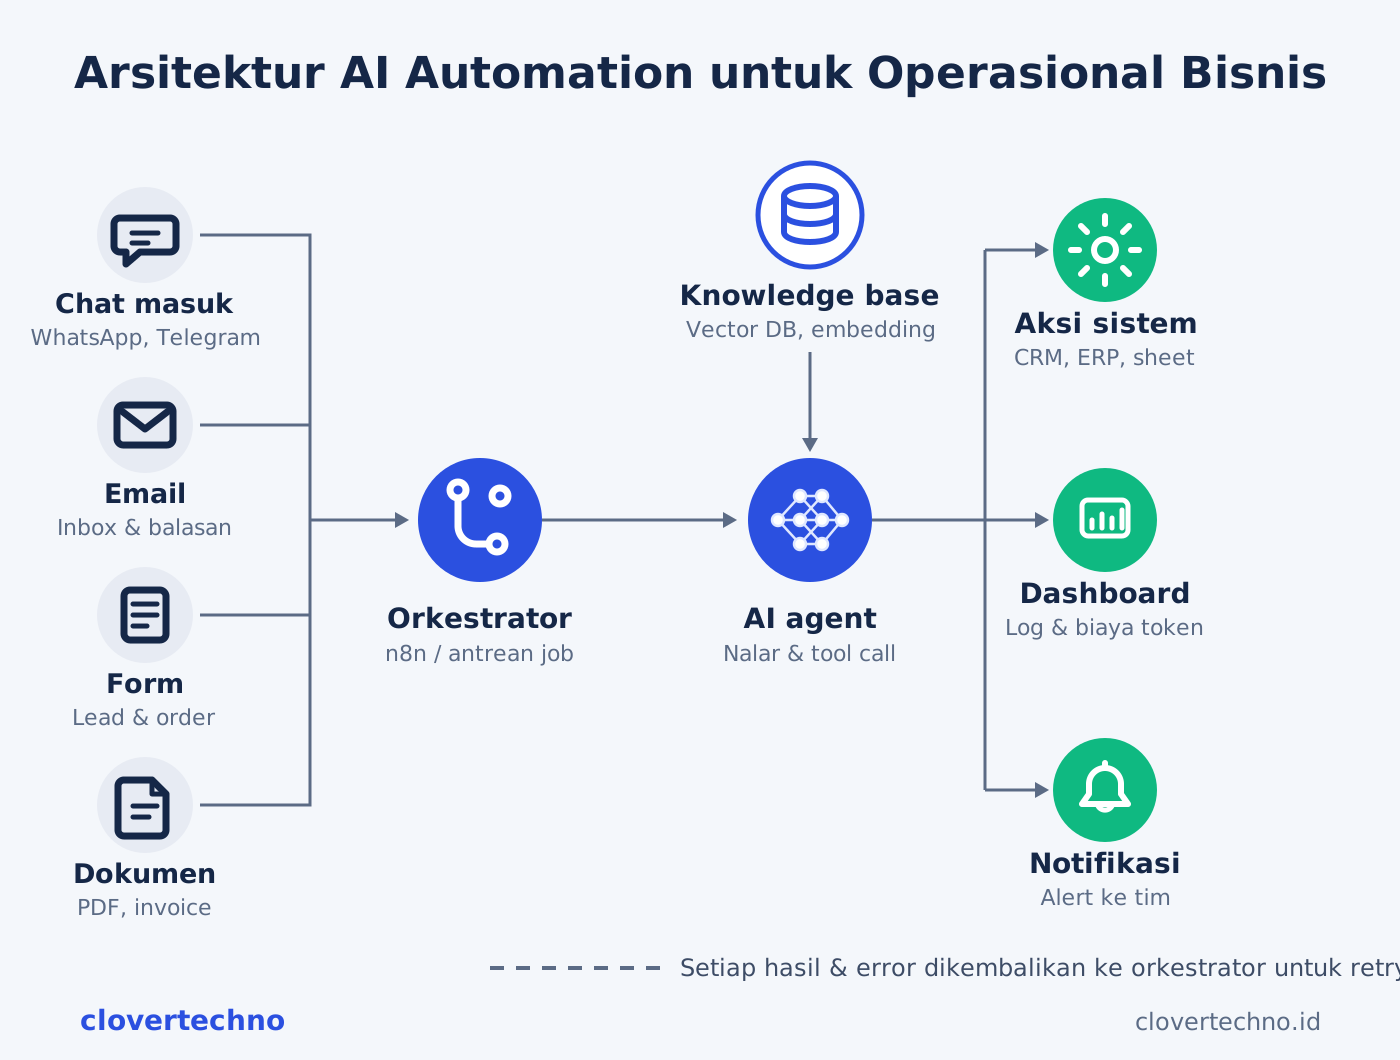
Klasifikasi hanya berguna kalau semua tiket melewatinya. Satukan kanal-kanal masuk ke satu workflow n8n: email lewat Gmail Trigger, form website lewat webhook, WhatsApp lewat Cloud API kalau Anda sudah memasangnya. Normalkan bentuknya di awal dengan node Set — apa pun kanalnya, setiap tiket keluar sebagai {sumber, pengirim, kontak, isi, waktu}. Investasi lima menit ini membuat seluruh hilir hanya perlu memahami satu bentuk data.
Langkah 2: Rancang kategori yang benar-benar dipakai tim
Kesalahan desain paling umum bukan di AI-nya — di kategorinya. Kategori yang baik lahir dari satu pertanyaan: apakah label ini mengubah siapa yang menangani atau seberapa cepat? Kalau tidak, ia hiasan. Mulai dari yang kasar dan terbukti dulu, misalnya lima: PEMBAYARAN (uang selalu prioritas), PENGIRIMAN, PRODUK_RUSAK, PERTANYAAN_UMUM, LAINNYA. Ditambah satu sumbu urgensi terpisah: TINGGI / NORMAL. Lima kategori yang dipakai mengalahkan lima belas yang diabaikan — dan menambah kategori belakangan jauh lebih mudah daripada melatih tim mempercayai sistem yang sejak awal membingungkan.
Langkah 3: Minta AI memberi label dan prioritas
Node AI — OpenAI untuk akurasi, atau Ollama kalau volume besar dan data sensitif — dengan prompt yang keluarannya bisa diparsing mesin:
Klasifikasikan tiket support berikut.
Jawab HANYA dengan JSON valid persis berformat:
{"kategori": "PEMBAYARAN|PENGIRIMAN|PRODUK_RUSAK|PERTANYAAN_UMUM|LAINNYA",
 "urgensi": "TINGGI|NORMAL",
 "alasan": "satu kalimat"}

Urgensi TINGGI hanya untuk: uang terpotong/hilang, pelanggan
sangat marah, atau masalah yang membesar kalau ditunda.
Kalau ragu antara dua kategori, pilih LAINNYA.

TIKET:
{{ $json.isi }}
Dua detail yang menjaga sistem ini waras: perintah "kalau ragu, pilih LAINNYA" memberi model jalan keluar selain menebak (tiket LAINNYA ditriase manusia — itu perilaku yang benar untuk kasus ambigu), dan field alasan membuat setiap keputusan bisa diperiksa saat Anda mengaudit kesalahan nanti. Setelah node AI, satu node Code mem-parsing JSON-nya, dengan cabang error untuk respons yang tak valid — pola karantina dari tutorial error handling.
Langkah 4: Arahkan tiket urgent ke jalur cepat
Label tanpa konsekuensi hanyalah dekorasi. Node Switch membagi alurnya: urgensi TINGGI memicu notifikasi seketika ke Telegram tim lengkap dengan isi tiket dan kontak pelanggan; kategori PERTANYAAN_UMUM boleh masuk antrean santai atau bahkan dijawab draft otomatis; sisanya dicatat berlabel ke Google Sheets atau sistem tiket Anda, sehingga pagi hari tim membuka antrean yang sudah terurut berdasarkan kepentingan, bukan berdasarkan jam kedatangan. Sheet berlabel itu sekaligus menjadi laporan bulanan gratis: kategori mana yang tumbuh, jam berapa puncaknya.
Mengukur akurasi dan menangani salah label
Jangan aktifkan konsekuensi di hari pertama. Minggu pertama, jalankan bayangan: sistem memberi label, manusia tetap triase seperti biasa, dan di akhir minggu bandingkan — dari sekian tiket, berapa label yang manusia setujui? Pengalaman kami dengan prompt yang dipagari baik, angkanya cukup tinggi untuk dipercaya pada kategori kasar; yang meleset hampir selalu kasus ambigu yang manusia pun akan berdebat. Dua aturan permanen setelah aktif: kesalahan arah ke atas (tiket biasa dilabeli TINGGI) itu murah — tim mengecek lalu lanjut; kesalahan ke bawah (tiket genting dilabeli NORMAL) itu mahal — maka bila ragu soal ambang urgensi, setel prompt agar condong ke TINGGI. Dan sediakan cara satu-klik bagi tim untuk menandai label yang salah; kumpulan koreksi itu adalah bahan penyempurnaan prompt bulan depan.
Dipasangkan dengan draft balasan otomatis, klasifikasi ini membentuk meja support yang memilah dan menyiapkan jawaban sendiri — manusia tinggal memutuskan. Ingin dipasangkan untuk bisnis Anda? Mulai dari sini.