Cara Membuat RAG Sederhana dengan Ollama dan Open WebUI
 Clovertechno
11 September 2026
3 menit baca
Model AI manapun, sepintar apa pun, tidak tahu isi SOP perusahaan Anda, syarat garansi produk Anda, atau kebijakan cuti kantor Anda. Ditanya soal itu, ia akan menjawab dengan percaya diri — dari tebakan. RAG (Retrieval-Augmented Generation) membalik situasinya: sebelum menjawab, sistem mencari potongan dokumen Anda yang relevan dan menyuruh model menjawab dari potongan itu saja. Hasilnya asisten yang menjawab dari dokumen perusahaan, bukan dari ingatan internet. Dan dengan Ollama plus Open WebUI, membangun versi sederhananya tidak butuh menulis kode sama sekali.
Cara kerja RAG dalam satu paragraf
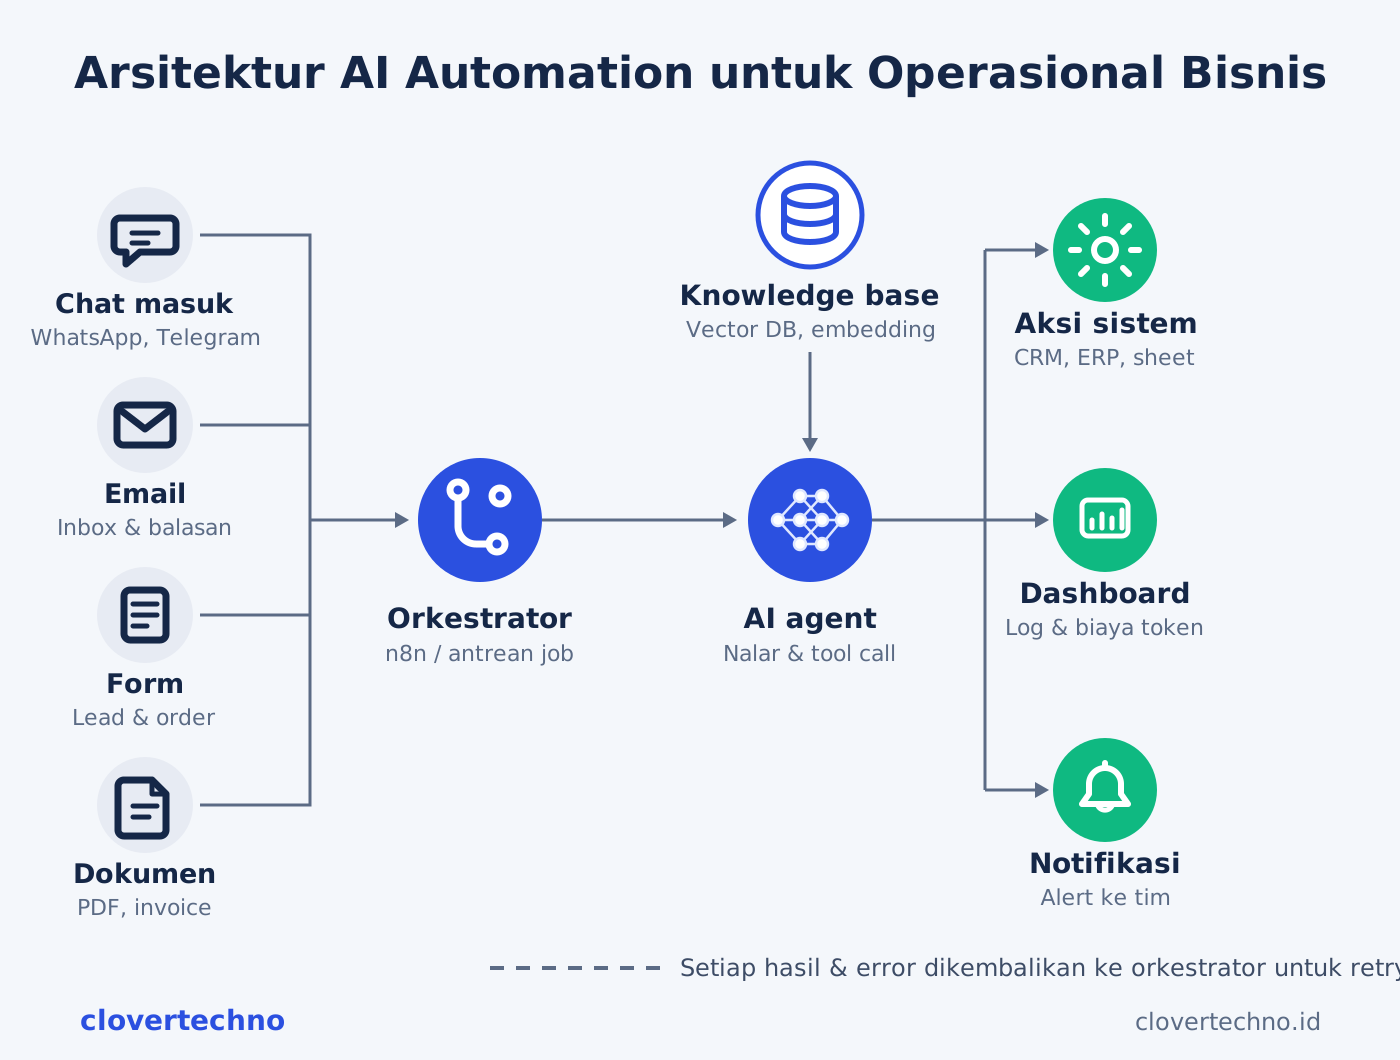
Saat dokumen diunggah, sistem memotongnya menjadi bagian-bagian kecil dan menyimpan "sidik jari makna" tiap potongan (embedding). Saat pertanyaan datang, sistem mencari potongan yang maknanya paling dekat dengan pertanyaan, lalu menyerahkan potongan-potongan itu ke model bersama pertanyaannya: "jawab dari bahan ini." Konsekuensi praktis yang penting dipahami: kualitas jawaban dibatasi oleh kualitas pencarian, dan kualitas pencarian dibatasi oleh kualitas dokumen. Di situlah kebanyakan proyek RAG menang atau kalah — bukan di kecanggihan modelnya.
Prasyarat: Open WebUI yang sudah tersambung ke Ollama.
Langkah 1: Siapkan dokumen yang layak jadi sumber
Setengah keberhasilan ditentukan sebelum satu byte pun diunggah:
- Pilih dokumen yang benar-benar jadi rujukan: SOP, katalog dan spesifikasi produk, kebijakan, FAQ internal. Bukan arsip email atau draft yang setengah jadi.
- Singkirkan versi kedaluwarsa. Ini penyebab kegagalan nomor satu: dua versi kebijakan di knowledge base berarti model mengutip yang lama dengan keyakinan penuh. Satu topik, satu dokumen, versi terkini.
- Utamakan teks asli, bukan hasil scan. PDF hasil scan adalah gambar; tanpa OCR isinya tak terbaca sistem. Kalau sumbernya scan, konversi dulu dan periksa hasilnya.
- Struktur menolong: dokumen berjudul dan bersub-judul jelas terpotong lebih rapi daripada tembok teks sepuluh halaman.
Langkah 2: Buat knowledge base di Open WebUI
Di menu Workspace → Knowledge, buat koleksi baru — beri nama spesifik seperti "SOP Operasional" atau "Katalog Produk", bukan "Dokumen" — lalu unggah file-file yang sudah dikurasi. Open WebUI mengurus pemotongan dan peng-embedding-annya di belakang layar. Buat koleksi terpisah untuk domain yang terpisah; asisten yang menjawab soal garansi tidak perlu mengaduk-aduk kebijakan cuti.
Langkah 3: Hubungkan model dengan knowledge base
Dua cara memakai koleksi itu. Cara cepat: di percakapan, ketik # lalu pilih koleksi — pertanyaan berikutnya dijawab dengan merujuk dokumen di dalamnya. Cara yang lebih rapi untuk pemakaian tim: buat model turunan di Workspace — pilih model dasar (misalnya Llama 3.1), lampirkan knowledge base, dan beri system prompt yang tegas:
Jawab HANYA berdasarkan dokumen yang dilampirkan.
Kalau jawabannya tidak ada di dokumen, katakan:
"Informasi ini tidak ada di dokumen saya."
Sebutkan dokumen mana yang jadi dasar tiap jawaban.
Hasilnya muncul sebagai model baru — semisal "Asisten SOP" — yang bisa dipilih siapa pun dari pemilih model, tanpa perlu tahu ada RAG di baliknya.
Langkah 4: Uji dengan pertanyaan yang jawabannya Anda tahu
Jangan menilai dari kesan; nilai dari skor. Susun sepuluh pertanyaan yang jawabannya pasti ada di dokumen (dan Anda tahu jawab benarnya), tiga pertanyaan yang jawabannya tidak ada di dokumen, lalu jalankan semuanya. Tiga hal yang dihitung: berapa yang dijawab benar, berapa yang dijawab salah dengan yakin (ini yang paling berbahaya), dan apakah tiga pertanyaan jebakan tadi dijawab jujur dengan "tidak ada di dokumen". Sistem yang lulus dua belas dari tiga belas siap dipakai tim dengan pengawasan; sistem yang mengarang di pertanyaan jebakan belum boleh keluar dari karantina.
Kenapa jawaban masih bisa salah dan cara menekannya
RAG menekan karangan bebas, tidak menghapusnya. Sumber salahnya bisa dipetakan — dan tiap sumber ada obatnya: potongan yang relevan tidak ditemukan (perbaiki struktur dokumen, perbesar jumlah potongan yang diambil), potongan ditemukan tapi model menyimpulkannya keliru (perketat system prompt, pakai model yang lebih besar), atau dokumennya sendiri yang salah (tidak ada teknologi yang menolong di sini — kurasi adalah pekerjaan manusia). Aturan pemakaian yang sehat: RAG lokal seperti ini luar biasa sebagai asisten pencari yang menghemat waktu membuka-buka dokumen; keputusan yang berdampak hukum atau uang tetap diverifikasi ke dokumen aslinya — yang untungnya kini selalu ikut disebutkan.
Versi yang lebih besar dari pola ini — vector database sendiri, pipeline pembaruan dokumen otomatis, integrasi ke sistem chat perusahaan — adalah wilayah layanan AI automation Clovertechno. Fondasi konsepnya bisa Anda perdalam di tutorial Ollama sebelum melangkah ke sana.