Halusinasi AI di Sistem Bisnis: Cara Membatasi Risikonya
 Clovertechno
12 Oktober 2026
6 menit baca
Sebuah asisten AI menjawab pertanyaan pelanggan tentang masa garansi. Jawabannya rapi, sopan, lengkap dengan nomor pasal kebijakan. Masalahnya, pasal itu tidak pernah ada. Pelanggan menyimpan tangkapan layarnya, dan tiga minggu kemudian tim Anda harus memilih antara menghormati janji yang tidak pernah dibuat atau berdebat dengan bukti tertulis dari sistem sendiri.
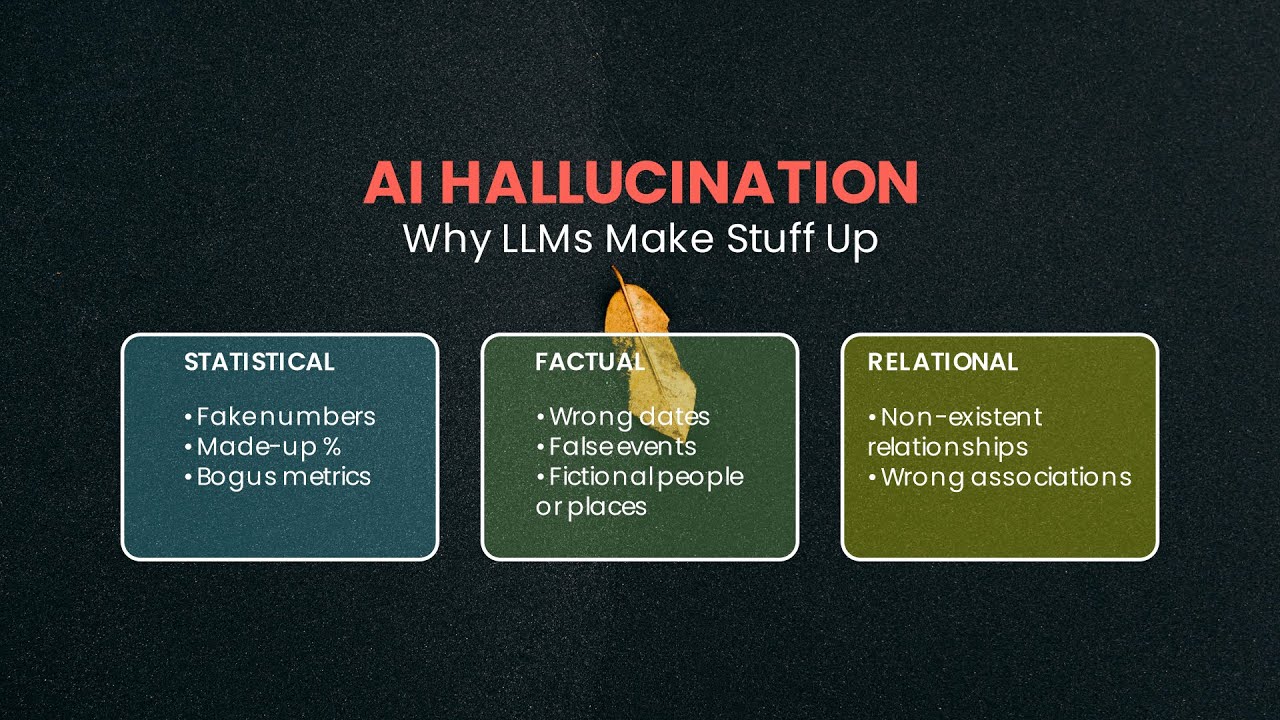
Ini yang disebut halusinasi: model menghasilkan keluaran yang terdengar benar tapi tidak berdasar pada data apa pun. Yang membuatnya berbahaya bukan tingkat kesalahannya, melainkan nada percaya dirinya. Sistem yang menjawab "saya tidak tahu" akan diverifikasi manusia. Sistem yang menjawab salah dengan mantap akan diteruskan begitu saja.
Kenapa model bisa yakin dan salah sekaligus
Model bahasa tidak menyimpan basis data fakta lalu mencarinya saat ditanya. Ia memprediksi kelanjutan teks yang paling masuk akal secara statistik. "Masuk akal" dan "benar" sering berimpit, tapi keduanya bukan hal yang sama, dan model tidak punya cara internal untuk membedakannya.
Konsekuensinya ada dua, dan keduanya penting saat merancang sistem bisnis:
- Tidak ada sinyal keyakinan yang bisa dipercaya. Kalimat yang benar dan kalimat yang dikarang keluar dengan gaya yang sama persis. Anda tidak bisa menyaring berdasarkan "nada ragu" karena nada itu tidak berkorelasi dengan kebenaran.
- Kekosongan diisi, bukan dibiarkan. Kalau dokumen Anda tidak memuat jawaban, model cenderung menyusun jawaban yang bentuknya mirip dengan jawaban yang biasanya ada di posisi itu. Nomor pasal, tanggal, dan nama orang adalah korban paling sering karena polanya sangat mudah ditiru.
Halusinasi juga naik tajam pada pertanyaan yang berada di pinggir pengetahuan sistem: hal spesifik perusahaan, kebijakan yang baru berubah, atau data yang muncul setelah model dilatih. Justru di situlah sebagian besar pertanyaan bisnis berada.
Tempat halusinasi paling merugikan
Tidak semua kesalahan berbiaya sama. Sebelum membangun pembatas, petakan dulu di mana kesalahan benar-benar mahal. Dari alur kerja yang biasa kami temui, urutannya kira-kira begini.
Keluaran yang langsung dibaca pihak luar
Balasan otomatis ke pelanggan, deskripsi produk, jawaban chatbot soal harga dan garansi. Kesalahan di sini tidak sempat dicegat siapa pun dan berubah jadi komitmen yang dianggap sah oleh penerimanya.
Angka yang masuk ke keputusan
Ringkasan laporan penjualan, rekap stok, atau ekstraksi nilai dari faktur. Satu digit yang salah tidak terlihat mencolok di paragraf ringkasan, tapi ikut terbawa sampai ke rapat dan ke keputusan pembelian.
Klasifikasi yang memicu tindakan otomatis
Misalnya sistem yang memberi label "keluhan berat" lalu otomatis mengeluarkan kompensasi, atau memberi label "spam" lalu menghapus. Kesalahan klasifikasi di alur seperti ini tidak meninggalkan jejak untuk diperiksa karena objeknya sudah telanjur diproses.
Yang risikonya rendah
Draf pertama tulisan, ide judul, ringkasan internal untuk dibaca sendiri, terjemahan kasar yang akan disunting. Di sini manusia sudah berada di jalur dan mengoreksi tanpa perlu proses formal. Menaruh kontrol berlapis di area ini hanya menambah biaya tanpa mengurangi risiko.
Aturan praktisnya: semakin jauh keluaran AI bisa berjalan tanpa dilihat manusia, semakin ketat pembatas yang harus dipasang di depannya.
Pembatas teknis: sumber, kutipan, dan validasi
Tiga lapisan berikut menutup sebagian besar kasus, dan ketiganya bisa dipasang tanpa mengubah model apa pun.
Kunci jawaban ke dokumen yang Anda miliki
Alih-alih membiarkan model menjawab dari pengetahuan umumnya, ambil dulu potongan dokumen yang relevan dari basis data Anda, lalu minta model menjawab hanya berdasarkan potongan itu. Instruksinya harus tegas: kalau jawaban tidak ada di bahan yang diberikan, sistem wajib menyatakan tidak menemukan, bukan menyusun perkiraan.
Ini memindahkan pekerjaan dari "mengingat" ke "membaca", dan membaca jauh lebih bisa diaudit.
Wajibkan kutipan yang bisa dilacak
Setiap jawaban menyertakan penunjuk ke sumbernya: nama dokumen, nomor halaman, atau ID baris. Manfaatnya dua arah. Manusia yang mengecek hanya perlu membuka satu halaman, bukan seluruh arsip. Dan sistem Anda bisa memverifikasi otomatis bahwa dokumen yang dikutip benar-benar ada dan benar-benar memuat kalimat itu. Kutipan ke dokumen yang tidak ada adalah sinyal halusinasi paling murah yang bisa Anda deteksi.
Paksa keluaran ke bentuk yang bisa divalidasi
Untuk tugas ekstraksi dan klasifikasi, minta keluaran terstruktur, bukan paragraf bebas. Setelah itu jalankan pemeriksaan biasa yang sudah Anda kenal dari pemrograman sehari-hari:
- Nilai kategori harus berasal dari daftar tertutup. Label di luar daftar ditolak, bukan diterjemahkan.
- Angka dicek terhadap rentang wajar. Faktur bernilai negatif atau seribu kali lipat rata-rata ditandai untuk diperiksa.
- Nomor referensi dicocokkan ke basis data. Kalau tidak ada di tabel, keluaran ditahan.
- Total harus konsisten dengan rinciannya. Penjumlahan yang tidak cocok berarti setidaknya satu baris salah baca.
Sebagian besar halusinasi yang mahal justru tertangkap di lapisan sederhana ini, bukan di lapisan AI yang canggih.
Pembatas proses: verifikasi manusia di titik mana
Menaruh manusia di setiap keluaran menghapus alasan mengotomasi. Menaruhnya di tempat yang tepat mempertahankan sebagian besar penghematan sambil menutup risiko terbesar. Gunakan pemetaan berikut sebagai titik awal, lalu sesuaikan dengan bisnis Anda.
| Sifat keluaran | Perlakuan |
|---|---|
| Dibaca pihak luar dan mengikat | Wajib disetujui manusia sebelum terkirim |
| Memicu transaksi atau perubahan data | Otomatis kalau lolos validasi, ditahan kalau ada satu saja aturan gagal |
| Masuk laporan pengambilan keputusan | Uji petik berkala, misalnya sepuluh baris tiap batch |
| Dipakai internal sebagai draf | Tanpa kontrol tambahan, cukup ditandai sebagai keluaran AI |
Dua detail yang sering terlewat. Pertama, tombol persetujuan harus lebih mudah ditekan daripada tombol perbaikan, tapi tidak boleh satu-satunya jalan cepat, karena kalau menolak jauh lebih repot daripada menyetujui, verifikasi akan berubah jadi formalitas dalam dua minggu. Kedua, setiap koreksi manusia harus tersimpan. Itulah bahan mentah untuk memperbaiki sistem, dan tanpa penyimpanan ini Anda hanya memperbaiki gejala satu per satu.
Cara mengukurnya secara berkala
Yang tidak diukur akan diklaim aman berdasarkan perasaan. Pengukurannya tidak perlu rumit.
Susun satu set pertanyaan uji, sekitar lima puluh sampai seratus, yang mencerminkan pertanyaan nyata dari lapangan, termasuk yang jawabannya memang tidak ada di dokumen Anda. Bagian terakhir ini penting: sistem yang baik harus lulus dengan menjawab "tidak ditemukan", dan tanpa kasus seperti itu di set uji, Anda tidak pernah menguji sisi yang paling rawan.
Catat jawaban benar sesuai sumber, jawaban salah, dan jawaban "tidak tahu" yang tepat. Jalankan set yang sama setiap kali ada perubahan: ganti model, ubah instruksi, tambah dokumen. Bandingkan dengan hasil sebelumnya. Kalau angkanya turun, Anda tahu perubahan mana penyebabnya, sesuatu yang mustahil diketahui kalau semuanya diubah sekaligus.
Di sisi produksi, pantau tiga hal: berapa persen jawaban yang dikoreksi manusia, berapa yang ditahan validasi, dan pertanyaan apa yang paling sering gagal. Pola dari daftar terakhir biasanya menunjuk ke dokumen yang hilang atau kebijakan yang belum ditulis di mana pun, bukan ke kelemahan model.
Kapan sebaiknya tidak memakai AI sama sekali
Ada kondisi di mana pembatas sebanyak apa pun tidak sepadan dengan hasilnya:
- Kesalahan tunggal berakibat fatal dan tidak bisa dibatalkan. Perhitungan dosis, kalkulasi pajak final, atau transfer dana tanpa jalur pembatalan. Gunakan aturan deterministik yang bisa diuji sampai tuntas.
- Jawabannya sudah pasti dan terbatas. Kalau pertanyaan pelanggan bisa dijawab tabel harga atau pohon keputusan sederhana, tabel itu lebih murah, lebih cepat, dan tidak pernah mengarang.
- Sumber datanya sendiri berantakan. AI yang membaca dokumen kedaluwarsa akan menjawab salah dengan rapi. Rapikan dokumennya dulu, itu pekerjaan yang tetap berguna walau Anda batal memakai AI.
- Volumenya kecil. Lima puluh dokumen sebulan tidak membenarkan biaya membangun, mengawasi, dan mengevaluasi sistem. Kerjakan manual, otomasi nanti saat volumenya naik.
Kami membangun sistem AI dengan asumsi bahwa modelnya suatu saat akan salah, lalu merancang alurnya supaya kesalahan itu tertahan sebelum menyentuh pelanggan atau data. Rincian pendekatannya ada di halaman AI automation, dan kalau kesimpulan Anda ternyata sistem terstruktur biasa lebih tepat untuk kasus Anda, itu ada di jasa pembuatan aplikasi. Bawa satu proses nyata beserta contoh dokumennya lewat halaman kontak, dan kita bisa menilai bersama mana lapisan yang benar-benar Anda butuhkan.